Cindy Mawamba

Étudiante ingénieure · Data Science & IA

Je transforme la donnée en décisions fiables. Au CESI, je travaille de la donnée brute jusqu'au modèle : je conçois des pipelines de données robustes, je structure les référentiels, j'entraîne des modèles d'IA et je développe les applications qui les rendent utiles. Rigueur, autonomie et curiosité guident mon travail.

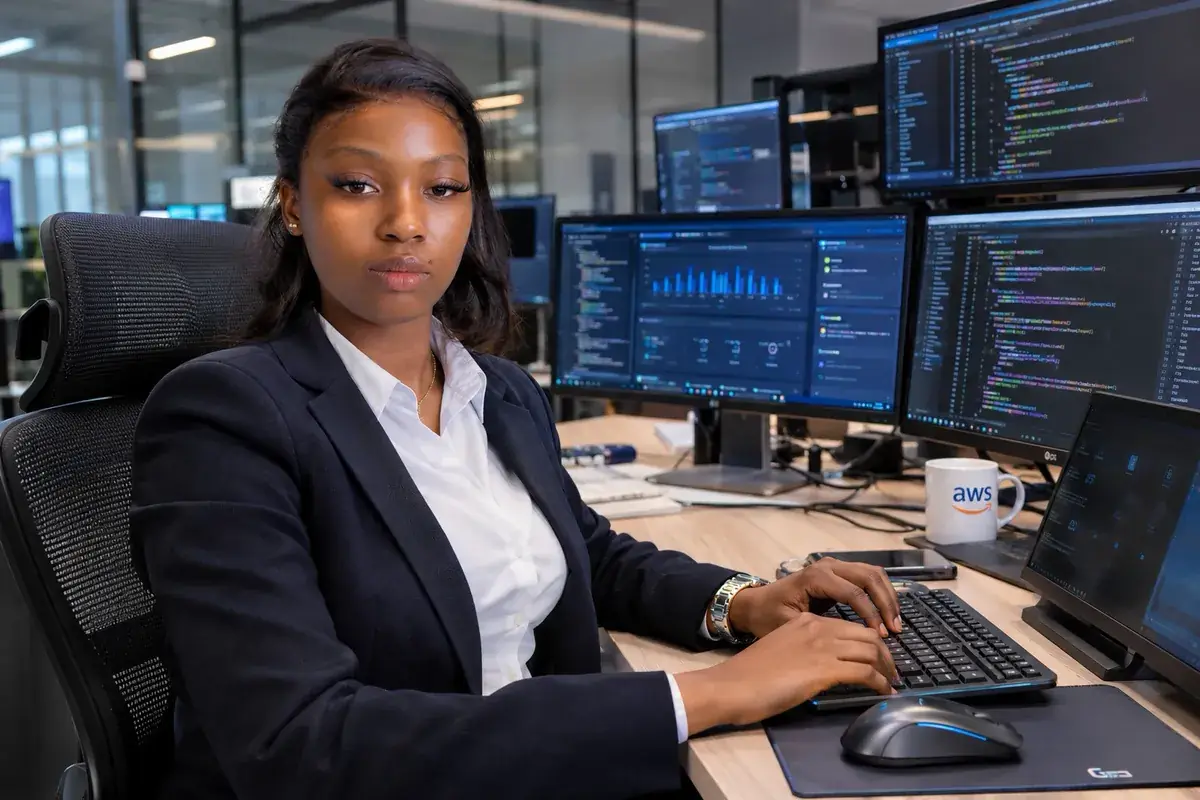
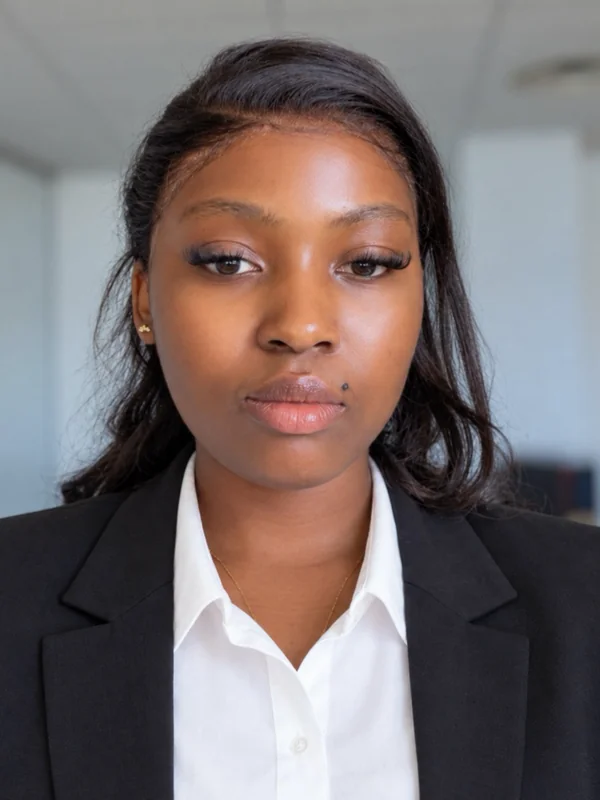
Cindy Mawamba au travail, devant ses écrans de développement
intelligence artificielle

De la donnée brute
à l'intelligence artificielle

à propos

Une formation d'ingénieure, des projets concrets.

Au fil de quatre stages, j'ai travaillé sur des pipelines ETL avec Talend, sur la gestion des données de référence avec EBX (MDM), sur une plateforme Django et sur un site web full stack.

À côté, mes projets couvrent le deep learning, le NLP, le Big Data, l'IoT et le développement d'applications.

J'aime les projets où la qualité de la donnée compte autant que la performance du modèle, et où l'IA reste équitable et explicable.
4stages réalisés
14projets
ETL · MDMTalend, EBX
Django · Reactfull stack
ma démarche

Comment je travaille

Comprendre le besoin

Je clarifie l'objectif métier et les données disponibles avant d'écrire la première ligne de code.

Fiabiliser les données

J'explore, je nettoie et je contrôle la qualité : un bon modèle commence par de bonnes données.

Construire par itérations

Je livre par sprints courts, en mode Scrum, avec des résultats mesurables à chaque étape.

Documenter et transmettre

Notebooks, schémas et rapports clairs, pour que l'équipe puisse reprendre et faire évoluer le travail.

En savoir plus sur moi →
compétences

Mes savoir-faire

Data engineering

ETLModélisation de donnéesGestion des données de référence (MDM)Entrepôt de donnéesBases relationnelles et NoSQLData visualisationTalendEBX (MDM)Power BISQL ServerpgAdmin

Data science

Analyse exploratoire (EDA)Nettoyage & préparation des donnéesFeature engineeringClassificationPrédiction (attrition, diabète)Détection de fraudeNLPOptimisation d'hyperparamètresÉvaluation de modèlesÉquité algorithmiquePandasScikit-learnOptunaAIF360

IA & Machine Learning

Deep learningRéseaux MLPAuto-encodeursImage captioningMLOpsTensorFlow / KerasCamemBERT

Développement

Développement full stackAPI RESTTâches asynchronesProgrammation orientée objetDjangoDjango REST FrameworkFlaskReactNestJSC#WordPressCeleryRedis

Méthodes

Scrum / AgileGit FlowUML / SysMLArchitecture microservicesCertification CiscoGit / GitHub

IoT & supervision

Architecture IoT Edge-to-CloudSupervision et tableaux de bordESP32MQTTLoRaWANNode-REDGrafana
technologies

Mon environnement technique

5
Structure
HTMLOssature des pages et des interfaces
3
Présentation
CSSMise en page et design adaptatif
JavaScript
Comportement
JavaScript · ReactInteractions et interfaces dynamiques
Node.js
Cerveau
Django · NestJS · Node.jsLogique métier et API
MySQL
Mémoire
PostgreSQL · MySQL · SQL ServerStockage et modélisation des données
Système nerveux
MQTT · Celery · RedisMessages, tâches asynchrones et temps réel
Communication
API RESTÉchanges entre services et applications
Python
Intelligence
Python · TensorFlow · CamemBERTModèles de machine learning et d'IA
Outils & langages
SQL
Requêtes
SQLInterrogation et modélisation de bases relationnelles
PHP
Web
PHPDéveloppement web côté serveur
Java
Langage
JavaProgrammation orientée objet
C / C++
Langage
C / C++Programmation système et orientée objet
Visual Studio
IDE
Visual StudioEnvironnement de développement intégré
VS Code
Éditeur
VS CodeÉditeur de code pour le développement au quotidien
Jupyter
Data science
JupyterNotebooks d'analyse et d'expérimentation
Déploiement
DockerConteneurisation et déploiement d'applications
Linux
Système
LinuxEnvironnement serveur et ligne de commande
Word · Excel · PowerPoint
Bureautique
Word · Excel · PowerPointDocumentation, analyses et présentations
Canva
Design
CanvaCréation de supports visuels
Voir toutes mes compétences →
ce que je fais

Mes domaines d'intervention

ETL

Pipelines de données

  • Extraction, transformation et chargement avec Talend
  • Des données propres et disponibles au bon moment
MDM

Données de référence

  • Modèles de données avec EBX
  • Rôles, droits d'accès et traçabilité
IA

Deep learning & ML

  • Préparation des données, entraînement et évaluation de modèles
  • TensorFlow / Keras et Scikit-learn
  • Démarche Scrum et MLOps
NLP

IA équitable et explicable

  • Scoring hybride avec embeddings sémantiques
  • Audit de biais et explicabilité
  • Dans l'esprit de l'AI Act
Dev

Applications full-stack

  • Python / Django, Flask, React, NestJS, PHP
  • PostgreSQL
  • Du modèle de données à l'interface, jusqu'au déploiement
IoT

Supervision temps réel

  • Collecte de capteurs avec ESP32 et MQTT
  • Traitement avec Node-RED
  • Visualisation en direct sur des tableaux de bord
Voir les services en détail →
data engineering

Le processus ETL

Extract
Extraire

Récupère et vérifie les données depuis leurs différentes sources

Bases relationnelles · fichiers CSV / Excel · API
Transform
Transformer

Nettoie, convertit et organise les données pour les rendre exploitables

Talend · règles métier · contrôle qualité
Load
Charger

Charge les données transformées dans la base ou l'entrepôt cible

PostgreSQL · entrepôt de données · référentiel EBX

Chaque étape est contrôlée pour que la donnée reste fiable, traçable et exploitable, de la source jusqu'à l'analyse.

expérience

Quatre stages en entreprise

Mon parcours en entreprise m'a permis d'acquérir une solide expérience en data engineering, en gestion des données de référence et en développement d'applications. J'ai travaillé sur des projets variés, des pipelines ETL avec Talend à la modélisation de référentiels avec EBX, en passant par une plateforme Django et un site web full stack.

4stages en entreprise
14projets présentés
55 CVanalysés par mon IA de recrutement équitable
projets

Ce que j'ai construit

NLP · IA responsable · Projet ADS

Nexura IA : un système ATS équitable et explicable

Les systèmes de tri de CV classiques cherchent des mots-clés : ils ratent des candidats qualifiés et peuvent reproduire des biais discriminatoires sans que personne ne le voie. Nexura IA est un prototype qui comprend le sens des CV grâce à CamemBERT, note chaque candidat selon quatre critères pondérés et audite l'équité de ses décisions.
Full-stack · Agent IA · Mai – Juin 2026

Transvirex Logistics : conception d'un ERP logistique intelligent

ERP logistique pour accompagner la transformation digitale d'une entreprise de transport en forte croissance (15 000 livraisons par mois, plus de 160 collaborateurs).

Deep learning · Mars 2026

Prédiction du diabète : BRFSS 2015

Projet de groupe de classification binaire sur le jeu de données de santé BRFSS 2015, mené en deux sprints Scrum / MLOps.

IoT · Février – Mars 2026

Système IoT Edge-to-Cloud de monitoring et de régulation environnementale

Conception et prototypage complet d'un système intelligent de monitoring et de régulation automatique pour des espaces collectifs : régulation thermique, qualité de l'air (CO₂), optimisation de l'éclairage et suivi d'occupation.

Deep learning · 2026 · Projet de groupe CESI

Projet Leyenda : client fictif TouNum

Projet de deep learning réalisé pour un client fictif, TouNum, en équipe de 4 personnes, avec deux livrables : une classification binaire, puis le débruitage de données.

Big Data · Mai – Juin 2025

Projet CHU : entrepôt de données pour le secteur hospitalier

Entrepôt de données et tableaux de bord décisionnels pour un groupe hospitalier (CHU), réalisés en équipe.

Application · Avril – Mai 2025

EasySave 3.0 : application de sauvegarde intelligente et interactive

Nouvelle version d'EasySave : application graphique de sauvegarde automatisée, sécurisée et optimisée pour les environnements professionnels.

Data science · Décembre 2024

Analyse des transactions bancaires pour la détection de fraudes

Comment analyser efficacement un jeu de données très déséquilibré pour identifier les transactions frauduleuses et construire un modèle fiable de prédiction des fraudes bancaires.

Machine learning · 2024

Prédiction de l'attrition des employés

Modèle prédictif des départs d'employés à partir de données RH, conçu dans le respect de l'éthique et de l'équité.

Base de données · 2023

Conception d'une base de données relationnelle

Projet mené en tant que chef de projet : concevoir une base de données à partir d'une analyse des besoins du client.

Application · POO · 2023

Application de gestion de données avec interface graphique

Projet de programmation orientée objet : une application qui gère des données via une interface graphique, reliée à une base SQL Server.

Web · PHP / MySQL · Full-stack

GEOMBMAP : site d'agence marketing

Site vitrine et commercial d'une agence de marketing digital, accompagné d'un espace d'administration pour suivre les ventes, les travaux et la facturation. Développé en full-stack en PHP et MySQL.

Web app · JavaScript

Verve : apprentissage de l'anglais

Application web autonome en un seul fichier HTML, sans dépendance externe, que j'ai créée pour progresser en anglais.

Web · Sept. 2023 · Projet personnel

Site e-commerce

Conception et développement d'un site marchand, de la modélisation jusqu'à la recette.

contact

Travaillons ensemble

Une opportunité en data engineering, Big Data ou IA ? Écrivez-moi, je réponds rapidement.

~/recrutement $ ./stage --data --ia --dev

> PROFIL HYBRIDE DÉTECTÉ (DATA + IA)

DISPONIBLE

STAGE • DATA • IA • DEV

COMPÉTENCES

  • Python · SQL
  • Talend · EBX (MDM)
  • Deep learning · NLP
  • CamemBERT · AIF360
  • Django · React
  • Power BI
SCAN 100%Portrait de Cindy Mawamba

DISPONIBILITÉ

  • Stage de fin d'études
    6 mois
  • Dès février 2027
  • Île-de-France
  • Cycle ingénieur Data Science & IA
    CESI Paris Nanterre
CINDY MAWAMBA
ATOUTUne stagiaire opérationnelle dès le jour 1
CONCEVOIR
STRUCTURER
ANALYSER
AUTOMATISER
CONTACTEZ-MOICV disponible en téléchargementÉcrire un e-mailMon CV